来源文章:https://openai.com/index/harness-engineering/
整理范围:
- 我们从一个空的 Git 代码仓库开始
- 重新定义工程师的角色
- 提高应用程序的可读性
- 我们将代码仓库设为记录系统
- 目标是智能体的可读性
- 规范架构与品味
- 吞吐量改变了合并的理念
- “智能体生成”实际上意味着什么
- 不断提高的自主水平
- 熵与垃圾收集
- 我们仍在学习的内容
一、我们从一个空的 Git 代码仓库开始
这一节像整篇文章的起点校准。
它要强调的不是“我们用 Codex 帮忙写了一些代码”,而是:
这个产品从最早的骨架开始,就是在“智能体优先”的前提下被建起来的。
也就是说,智能体不是后期接入研发流程的插件,而是从 repo 初始化、脚手架搭建、CI 配置、格式化规则、包管理器选择、应用框架设定开始,就已经是主要执行者。
1. 这一节的核心意思
原文给出的设定非常极端,也因此很有解释力:
- 首次提交发生在一个空的 Git 仓库中
- 初始架构由 Codex CLI 在少量模板指导下生成
- 连最初的
AGENTS.md都是由 Codex 编写 - 整个系统没有预存任何人工编写的产品代码
五个月后,这个仓库已经发展到约一百万行代码,覆盖:
- 应用逻辑
- 基础设施
- 内部工具
- 文档
- 开发者工具
与此同时,大约 1,500 个 PR 被打开与合并,而驱动这一切的最初只是一个三人小团队。
这一节真正想建立的认知是:
OpenAI 讨论的不是“AI 辅助编程”,而是“从零开始、以 agent 为主要执行体来组织软件生产”。
这会彻底改变后文所有讨论的重心。
2. 为什么这一节重要?
因为如果不先明确这个前提,后面很多判断会显得夸张,甚至像宣传语。
例如:
- 为什么要把应用程序做得对 agent 可读?
- 为什么要把 repo 变成记录系统?
- 为什么要重做 merge philosophy?
- 为什么要引入 garbage collection?
如果 agent 只是一个偶尔帮忙的工具,这些投入都会显得过重。
但如果 agent 是主要执行体,那这些投入就不再是优化项,而是:
维持整个研发系统可运转的基础设施。
也就是说,这一节的作用是把整篇文章从“一个工具使用案例”抬升为“一个新型研发范式实验”。
3. 这一节最值得注意的两个信号
1)“人类掌舵,智能体执行”
这句其实是全文的治理基调。
它意味着:
- 人类不再主要通过亲手写代码创造价值
- 人类的核心价值转向目标设定、环境设计、反馈回路构建与质量判断
- agent 成为主要的实现者
换句话说:
人类从直接生产代码,转向设计“代码如何被生产”的系统。
2)“没有人工直接提交代码”
这不是噱头,而是一种方法论压力测试。
因为一旦人类可以随手下场补代码,很多系统性问题都会被掩盖:
- harness 不够强时,人类会偷偷补上
- 文档不够清晰时,人类会临场解释
- 工具不够好时,人类会手工绕过去
而在“人类不手写代码”的约束下,所有这些缺口都会暴露出来。
所以这是一种逼迫组织把隐性能力显式化的实验设计。
4. 这一节的真正含义
如果把它压缩成一句话,我会这样总结:
OpenAI 不是在证明 agent 能不能写代码,而是在测试:如果 agent 成为主要执行体,软件工程体系需要从第一天起长成什么样子。
这是非常不一样的问题。
前者像工具评测,后者像生产系统设计。
5. 直白版总结
这篇文章的起点,不是“让 AI 帮程序员更快写代码”,而是“假设 AI 从第一天就是主要施工队,整个工地该怎么设计”。
二、重新定义工程师的角色
这一节真正讲的是:
当人类不再直接写代码时,工程师到底还在做什么?
作者给出的答案非常明确:工程师并没有消失,而是把主要精力从“手工实现”转移到了“设计系统、拆解任务、提供反馈、为智能体创造杠杆”。
1. 这一节的核心意思
原文里有一个非常关键的观察:
早期进展比团队预期慢,不是因为 Codex 不够强,而是因为环境不够清晰。
换句话说,瓶颈不在模型智力,而在:
- 缺少足够明确的工具
- 缺少可组合的抽象
- 缺少智能体可读的内部结构
- 缺少让高级目标落地的执行支点
于是工程团队的工作发生了重心迁移:
- 不是替智能体写代码
- 而是帮助智能体能够写出有用的代码
这就是这一节的本质。
2. 工程师角色发生了什么变化?
作者把这种工作方式描述为一种“深度优先”的推进模式:
- 先把大目标拆成更小的构建模块
- 让智能体分别去做设计、代码、评审、测试等子任务
- 再把这些模块组合起来,去解锁更复杂的任务
这意味着工程师的核心工作不再是“亲手补实现”,而变成:
- 定义任务
- 拆解目标
- 判断智能体目前缺什么能力
- 补工具、补约束、补文档、补结构
- 让下一轮智能体执行更顺畅
所以工程师的角色更像:
- 系统设计者
- 杠杆放大器
- 工作流编排者
- 约束制定者
- 反馈回路维护者
而不再只是“代码作者”。
3. 这一节最重要的一句话可以怎么理解?
原文有个很值得反复咀嚼的判断:
当事情进展不顺利时,解决方案基本上不再是“再努力一点”。
这句话背后意味着一个非常深的范式变化。
在传统工程里,遇到阻碍,人类常见的默认动作是:
- 多加班
- 多写点代码
- 手动修一下
- 直接顶过去
但在 agent-first 的系统里,这种路径价值会下降。
真正有效的问题变成:
究竟还缺什么能力,才能让智能体自己把这件事做完?
这会把工程师的注意力强制从“局部救火”拉回到“系统增能”。
4. 人类如何与系统交互?
原文里另一个很重要的点是:
人类几乎完全通过提示与系统交互。
工程师做的是:
- 描述任务
- 运行智能体
- 允许其打开 PR
- 要求其本地自审
- 要求额外的智能体审查
- 让其响应反馈并反复迭代
这意味着什么?
意味着工程师的“操作界面”已经从 IDE 键盘输入,转向了:
- 任务描述
- 目标对齐
- 审核判断
- 反馈注入
- 流程推进
从这个角度看,工程师更像在操作一个复杂生产系统,而不是直接雕刻每一行代码。
5. 这一节的组织含义
如果把这一节往组织层面翻译,它其实在说:
工程师的产出,不再主要由“自己写了多少代码”衡量,而更多由“自己让系统多释放了多少生产力”衡量。
这会改变很多事情:
- 什么算高价值工作
- 什么算好的工程判断
- 什么算优秀工程师
- 团队该如何分工
- 平台团队的重要性为什么会上升
也就是说,工程师并不是被 agent 替代,而是被迫升级。
6. 这一节的直白版总结
在 agent-first 的研发里,工程师最重要的工作不再是自己把代码写出来,而是把环境设计到“智能体能够持续把代码写对”。
三、提高应用程序的可读性
这一节真正讲的不是“让代码更好读”,而是:
让应用本身变成 agent 可直接观察、操作、验证的对象。
也就是把过去需要人肉 QA、人肉看日志、人肉点页面的环节,尽量改造成 Codex 自己就能看、能测、能定位、能修 的闭环。
1. 核心意思
前面 OpenAI 已经把“写代码”交给了 Codex。 接下来新的瓶颈就变成了:谁来验证这些代码真的工作?
如果 PR 吞吐量很高,但每次都要靠人手工:
- 打开页面点一遍
- 看控制台
- 查日志
- 看指标
- 判断问题出在哪
- 修完再验证
那人类 QA 就会成为整个系统的最窄瓶颈。
所以他们做的事情是:
-
让 Codex 能自己操作应用 - 为每次改动启动一个独立实例 - 接入 Chrome DevTools - 让它看 DOM、截图、导航、交互
-
让 Codex 能自己看运行状态 - 直接查日志 - 直接查 metrics - 直接看 traces - 自己关联“哪个改动导致哪种性能/稳定性问题”
-
让 Codex 在隔离环境里自己循环 - 复现 bug - 改代码 - 重启应用 - 再跑一遍 - 再验证 - 直到通过
所以“提高应用程序的可读性”,本质上是:
把应用从“给人看的黑箱”改造成“给 agent 看的透明系统”。
2. 第一个流程图:Codex 用浏览器驱动应用,自主验证修复
这个图可以理解成:
[人类给任务]
   ↓
“修复某个 bug / 完成某个功能 / 验证某条用户路径”

   ↓
[Codex 在该改动对应的独立 worktree 中启动应用实例]
   ↓
每个任务有自己的隔离环境
不会污染主分支或其他任务环境

   ↓
[Codex 通过 Chrome DevTools / 浏览器技能操作应用]
   ↓
- 打开页面
- 导航到目标位置
- 点击按钮
- 输入表单
- 触发用户路径
- 抓 DOM snapshot
- 截图
- 观察页面变化

   ↓
[Codex 判断是否复现问题 / 功能是否生效]
   ↓
看这些证据:

- 页面有没有报错
- 元素是否出现/消失
- DOM 是否符合预期
- UI 是否卡住/空白/错位
- 交互是否真的完成

   ↓
┌──────────────────────────────┐
│ 如果没通过 / 复现了 bug      │
└──────────────────────────────┘
   ↓
[Codex 回到代码库修改代码]
   ↓
- 调整实现
- 增补测试
- 修复逻辑
- 更新配置

   ↓
[重启应用 / 重新部署本地实例]
   ↓
[再跑一遍同样的用户路径]
   ↓
[再次截图 / 再看 DOM / 再验证]
   ↓
  是否通过?
   ├─ 否 → 继续循环
   └─ 是 → 进入 PR / 审查 / 合并流程
图一的本质一句话
让 agent 不只是“写完代码就停”,而是能自己像测试工程师一样把页面跑通。
图一最关键的 4 个能力点
- 独立实例:每个改动都有自己的 app 实例,agent 可以大胆试,不怕互相影响。
- 浏览器可操作:不是只看代码,而是真能“像用户一样”使用产品。
- 页面状态可观测:能抓 DOM、截图、导航结果、页面前后状态。
- 可重复循环:不是一次性试,而是修完就再跑,直到通过。
3. 第二个流程图:Codex 直接使用日志/指标/追踪做调试
这个图可以翻成:
[应用在独立环境中运行]
   ↓
应用在用户操作或测试过程中产生运行信号:

- Logs(日志)
- Metrics(指标)
- Traces(链路追踪)

   ↓
[这些信号被收集到本地可观测性堆栈]
   ↓
例如:

- Vector 负责收集/转发
- 日志后端
- 指标后端
- 追踪后端

   ↓
[Codex 直接查询这些运行数据]
   ↓
- 用 LogQL 查日志
- 用 PromQL 查指标
- 用 TraceQL 查链路
- 关联不同信号判断问题根因

   ↓
[Codex 形成诊断]
   ↓
例如:

- 某接口超时
- 某启动流程太慢
- 某用户旅程某一段超过 2 秒
- 某请求报 500
- 某数据库查询异常
- 某服务重试过多

   ↓
[Codex 回到代码库实施修复]
   ↓
- 改代码
- 改配置
- 改调用链
- 补监控/补测试

   ↓
[重启应用]
   ↓
[重新跑 workload / UI 路径]
   ↓
[再次读取 logs / metrics / traces]
   ↓
  是否达到目标?
   ├─ 否 → 继续循环
   └─ 是 → 输出修复结果
图二的本质一句话
让 agent 不只会“看到坏了”,还会“知道为什么坏”。
图二最关键的意思
它表达的是:
可观测性不再只是给 SRE / 人类工程师看的 dashboard,而是 agent 的调试输入。
两个图合起来的完整闭环
[任务]
   ↓
[Codex 修改代码]
   ↓
[启动独立应用实例]
   ↓
[图一:跑 UI / 走用户路径]
   ↓
看外部现象:

- 页面
- DOM
- 截图
- 交互结果

   ↓
[图二:查内部运行信号]
   ↓
看内部证据:

- 日志
- 指标
- 追踪

   ↓
[Codex 推理问题根因]
   ↓
[修改代码]
   ↓
[重启]
   ↓
[重新跑 UI + 重新查观测数据]
   ↓
通过后提交 PR / 合并
一句话总结
如果你只让 AI 写代码,它只是一个更快的程序员;如果你让 AI 看见应用、看见日志、看见指标、看见追踪,它才开始像一个能独立调试和交付的工程系统。
4. 企业要做类似 OpenAI 这套 agent harness,平台至少要有哪些能力?
我把它拆成 8 个核心模块:
1)任务编排层
- 任务创建与分发
- 子任务拆解
- 状态跟踪
- 超时/重试/人工接管
2)代码执行层
- 读写代码仓库
- 建分支 / worktree
- 跑测试 / 构建 / 提交 PR
3)浏览器与 UI 操作层
- 打开页面
- 点击 / 输入 / 导航
- DOM snapshot
- screenshot
- console/network 读取
4)可观测性层
- 日志查询
- metrics 查询
- traces 查询
- 与当前任务实例绑定
5)环境隔离层
- branch/worktree 隔离
- 临时服务实例
- 独立数据库或测试数据集
- 独立日志/指标命名空间
6)知识与上下文层
- 架构说明
- 产品规格
- 执行计划
- 决策日志
- references / runbooks / llms.txt
7)规则与约束层
- lint
- architecture rules
- dependency boundary checks
- naming convention
- security / reliability guardrails
8)审查与闭环层
- agent 自审
- 多 agent review
- 人工 review 插入点
- PR comment 回流
- merge gate
极简总结
企业级 coding agent 平台,不是“接一个大模型 + IDE 插件”就够了, 而是要补齐:
- 任务编排
- 执行环境
- UI 验证
- 可观测性
- 知识系统
- 规则约束
- 交付闭环
真正的竞争力在于 harness,不只是 model。
5. 本节生成的信息图
信息图 1:让 Agent 看得见“用户界面”
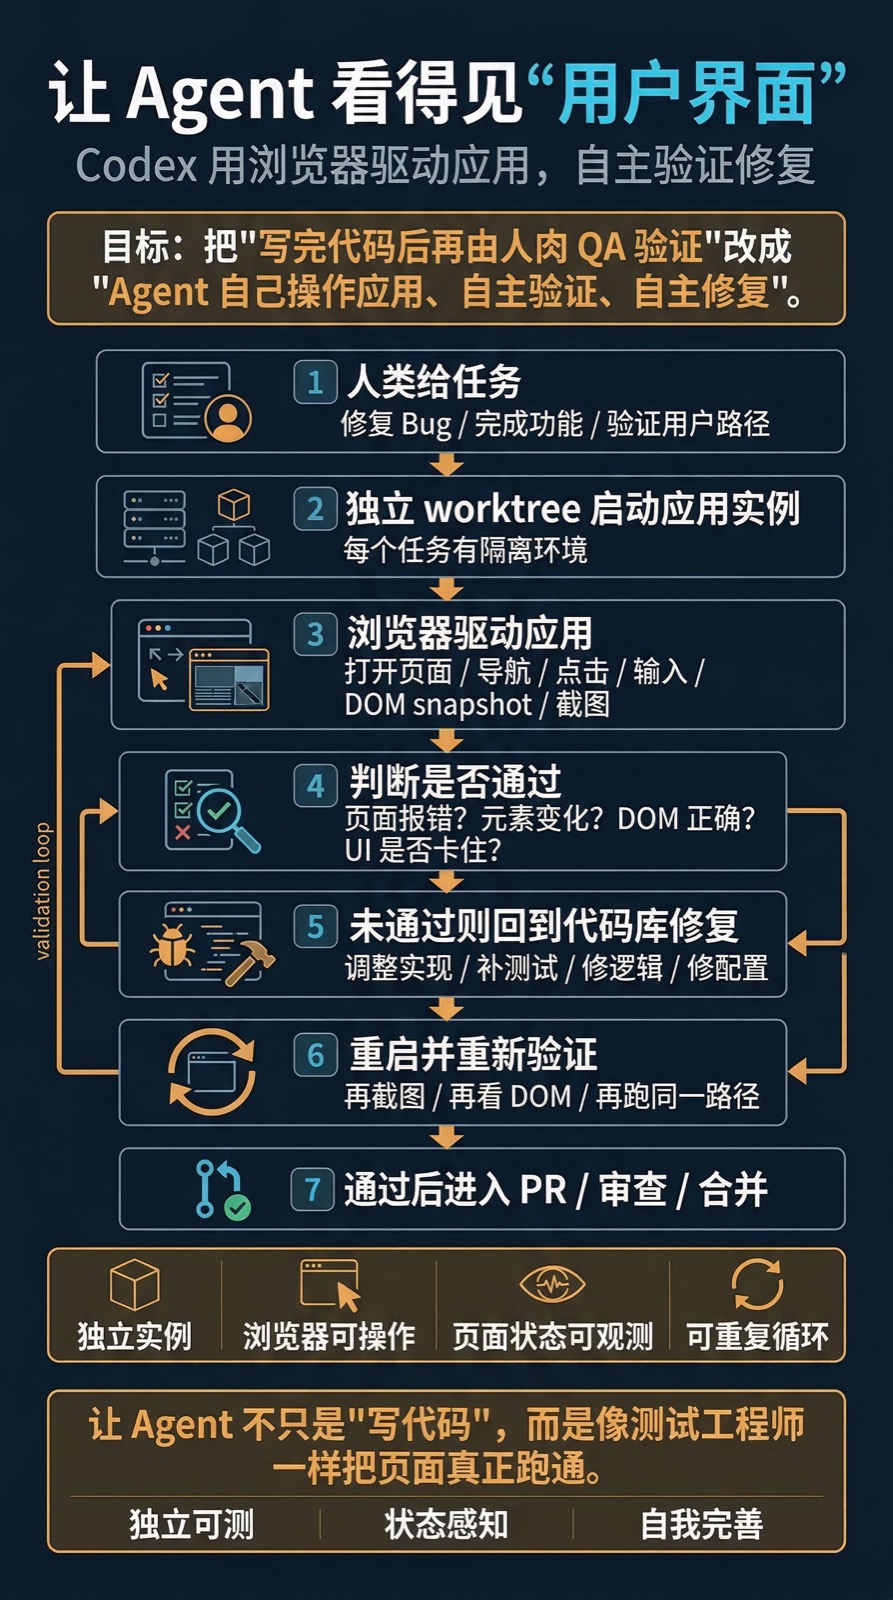
图片路径: 产物/专题信息图/openai-harness-flow-1-ui-validation/infographic.png
信息图 2:让 Agent 看得见“系统内部”
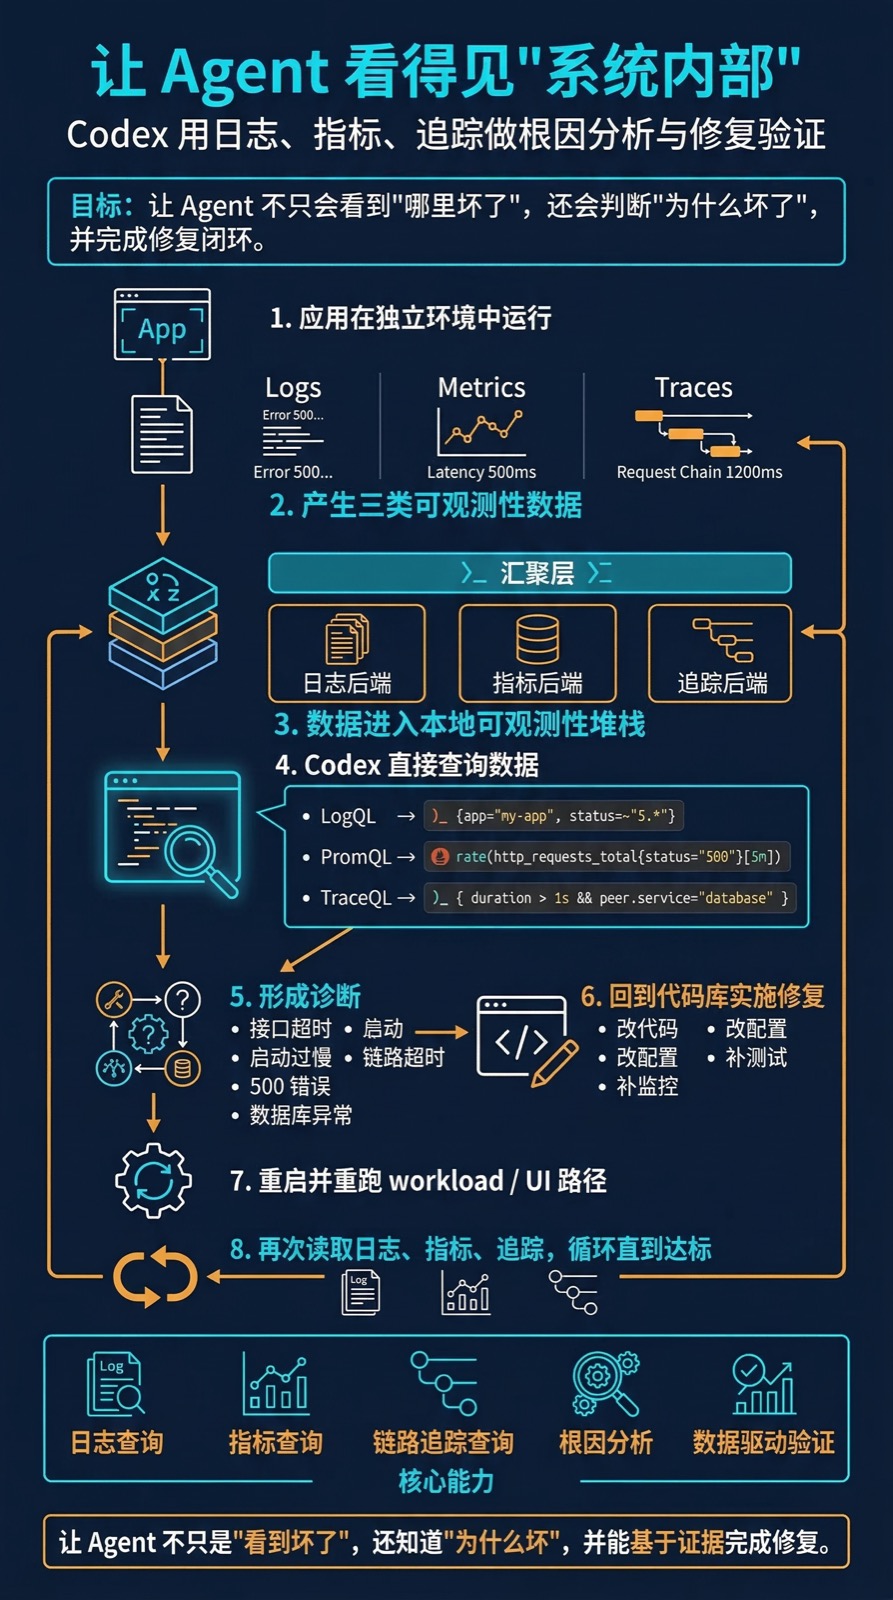
图片路径: 产物/专题信息图/openai-harness-flow-2-observability/infographic.png
---
四、我们将代码仓库设为记录系统
这一节如果说得最直白一点,就是:
不要给 Codex 一本超长说明书;要给它一张地图,以及一个结构化、可导航、可验证、持续更新的代码仓库知识系统。
1. 核心意思
他们发现,agent 在复杂任务里最大的问题之一不是“不会写代码”,而是:
- 不知道该看哪里
- 不知道哪些规则仍然有效
- 不知道某个设计决定在哪里
- 不知道上下文的边界
- 被过量说明淹没
所以他们做了一个根本转变:
不是把 AGENTS.md 写得越来越长
而是把 repo 本身改造成:
- 知识库
- 记录系统
- 决策容器
- 执行计划仓库
- 长期上下文的承载体
2. 这一节最重要的一句话
给 Codex 的应该是一张地图,而不是一本 1000 页的说明书。
这句话其实是在讲 agent 时代的上下文工程原则。
因为模型上下文有三个现实问题:
- 上下文是稀缺资源
- 长文档会挤占真正重要的任务信息
- 大而全的说明书很快就腐烂
所以 OpenAI 不再把 AGENTS.md 当“百科全书”,而是当:
- 入口
- 目录
- 地图
- 路由器
3. 他们为什么反对“大 AGENTS.md”?
1)它会挤占上下文窗口
如果你给 agent 一个超长 instruction 文件,那它就会少看到:
- 当前任务
- 当前代码
- 当前报错
- 当前文档
结果是:
本来该关注当前问题,结果被一堆历史规则淹了。
2)“所有东西都重要”就等于“没有东西重要”
如果说明书里什么都写、什么都强调,模型很难判断优先级。 最后会变成一种浅层 pattern matching,而不是理解“这一刻最重要的约束是什么”。
3)大说明书会迅速腐烂
一旦人不持续维护,一个大手册很容易变成:
- 旧规则
- 半真半假的经验
- 已经过期的约束
- 没人知道还算不算数的内容
而 agent 最大的问题是:
它通常不擅长自己判断“这条规则是不是过时了”。
4)单个大文件很难自动校验
一个巨大的 blob 不适合做:
- ownership
- freshness
- coverage
- cross-link
- lint
- CI 校验
所以知识漂移几乎不可避免。
4. 所以他们改成了什么?
他们把 repo 设计成一个分层、结构化的知识系统,大致结构如下:
AGENTS.md
ARCHITECTURE.md
docs/
├── design-docs/
├── exec-plans/
├── generated/
├── product-specs/
├── references/
├── DESIGN.md
├── FRONTEND.md
├── PLANS.md
├── PRODUCT_SENSE.md
├── QUALITY_SCORE.md
├── RELIABILITY.md
└── SECURITY.md
这不是普通“文档多一点”的意思,它背后有 4 个关键原则。
5. 原则 1:AGENTS.md 只做地图,不做百科全书
AGENTS.md 的职责变成:
- 告诉 agent 这个 repo 怎么导航
- 关键规则在哪看
- 什么问题去哪里找
- 什么文档是权威来源
- 下一步该跳转到哪个文件
所以它像一个目录页 + 路线图。
6. 原则 2:真正的知识分门别类存放在 repo 中
A. design-docs
存设计理念、核心信念、设计决策。
B. exec-plans
存执行计划、进度、决策日志、技术债。
C. generated
存生成产物,比如 schema。
D. product-specs
存产品规格说明。
E. references
存参考资料、第三方约束、工具说明。
F. 顶层专项文档
比如:
- ARCHITECTURE
- RELIABILITY
- SECURITY
- PRODUCT_SENSE
这些其实是在给 agent 一套“判断问题时的坐标系”。
7. 原则 3:计划是第一类工件,不是临时聊天记录
OpenAI 明确说:
计划被视为一流工件。
也就是说,复杂任务不是靠聊天上下文撑着,而是靠 repo 内的执行计划文件撑着。
这意味着:
- 小改动可以临时做
- 复杂工作必须有 plan
- plan 要写进 repo
- progress / decisions / debt 要版本化
这样做的价值很大,因为 agent 最怕的是:
每次任务都从头“重新理解发生了什么”。
8. 原则 4:采用“渐进式披露”,不要一次灌满
文里用了一个非常好的词:progressive disclosure。
意思是:
- agent 从小而稳定的入口开始
- 先拿到地图
- 再按需要深入到具体文档
- 而不是一开始把整个知识库都塞进上下文
对 agent 特别有效,因为模型最怕两种情况:
- 信息太少,无法推理
- 信息太多,无法聚焦
progressive disclosure 就是在解决这个矛盾。
9. 他们为什么说“代码仓库是记录系统”?
这里的“记录系统”不是单纯指存代码, 而是说 repo 成了 agent 可访问世界里的 事实源头(source of truth)。
从 agent 视角看:
能看到的,才存在
- 代码
- markdown
- schema
- 计划
- 版本化决策
- 规则文档
看不到的,就等于不存在
- Google Docs
- Slack 聊天
- 飞书群讨论
- 某个同事脑子里的共识
这就是这一节和下一节“目标是智能体的可读性”之间的桥。
10. 这对团队意味着什么变化?
这其实不只是技术改造,而是组织工作方式的改造。
过去
知识散落在:
- 会议
- IM
- Docs
- PR 评论
- 口头共识
现在如果想让 agent 有效
必须把关键知识沉淀成:
- 可版本化
- 可链接
- 可检索
- 可校验
- 可持续维护
也就是说:
知识管理,从“方便人找”升级为“必须让 agent 找得到”。
11. 文里另外两个很值得注意的点
1)他们用 linter 和 CI 来检查知识库本身
不是只 lint 代码,也 lint 文档系统。
检查:
- 是否更新
- 是否交叉链接
- 是否结构正确
- 是否过时
这说明他们已经把文档系统当成“生产基础设施”了。
2)他们甚至有 “doc-gardening” agent
也就是专门跑一个 agent:
- 扫描过时文档
- 找不再匹配真实代码行为的内容
- 自动发 PR 修文档
这说明在 agent-first 环境里,文档不是附属品,而是运行条件的一部分。
12. 中文文字版结构图 / 流程图
结构图一:从“大说明书”切换到“地图 + 结构化知识库”
旧模式:一个超长 AGENTS.md

AGENTS.md(超长)
├── 规则
├── 设计理念
├── 产品规格
├── 技术债
├── 执行计划
├── 历史决策
├── 团队习惯
└── 各种补充说明

问题:

- 挤占上下文窗口
- 优先级不清
- 很快腐烂
- 很难校验
- agent 不知道该先看什么
新模式:地图 + 分层知识系统

AGENTS.md(短)
├── 这个仓库怎么导航
├── 关键规则去哪看
├── 产品信息去哪看
├── 架构信息去哪看
└── 当前复杂任务去哪看

ARCHITECTURE.md
└── 顶层架构地图

docs/
├── design-docs/        → 设计理念 / 核心信念 / 设计决策
├── exec-plans/         → 执行计划 / 进度 / 决策日志 / 技术债
├── generated/          → schema 等生成产物
├── product-specs/      → 产品规格 / 用户流程 / 功能定义
├── references/         → 外部参考 / 工具说明 / 依赖说明
├── RELIABILITY.md      → 稳定性要求
├── SECURITY.md         → 安全要求
├── PRODUCT_SENSE.md    → 产品判断标准
└── QUALITY_SCORE.md    → 质量追踪与差距
结构图二:Agent 如何在“记录系统”中导航
[收到任务]
   ↓
[先读短 AGENTS.md]
   ↓
知道:

- 仓库怎么走
- 关键规则在哪
- 当前应该先看哪类文档

   ↓
[按任务类型跳转]
   ├─ 做产品功能 → 看 product-specs/
   ├─ 做架构调整 → 看 ARCHITECTURE.md / design-docs/
   ├─ 做复杂任务 → 看 exec-plans/
   ├─ 查外部约束 → 看 references/
   ├─ 查稳定性要求 → 看 RELIABILITY.md
   └─ 查安全要求 → 看 SECURITY.md

   ↓
[读取局部、相关、权威的上下文]
   ↓
不是一次吞下全部知识,而是按需深入

   ↓
[执行任务]
   ↓
[把新增知识写回 repo]
   ↓
例如:

- 更新执行计划
- 记录决策日志
- 补充规格说明
- 修正文档偏差
- 添加技术债记录

   ↓
[CI / lint / doc-gardening 检查知识系统]
   ↓
保证:

- 文档结构正确
- 交叉链接完整
- 内容不过时
- 文档和真实代码一致
流程图三:为什么说“代码仓库是记录系统”
团队知识产生
   ↓
可能来自:

- 设计讨论
- 架构决策
- 产品评审
- 执行过程
- Bug 修复经验
- 技术债识别

   ↓
如果只停留在:

- Slack / 飞书 / IM
- Google Docs
- 会议口头共识
- 某个人脑子里

   ↓
对 agent 来说 = 不存在

   ↓
所以必须沉淀进 repo:

- Markdown 文档
- 计划文件
- 决策日志
- schema
- 规则文件
- references

   ↓
沉淀后的结果:

- 可版本化
- 可检索
- 可链接
- 可校验
- 可被 agent 读取

   ↓
于是 repo 从“代码容器”升级为“事实源头 / 记录系统”
一句话理解这组图
不是把所有知识都塞进一个超长说明书里, 而是把知识拆进 repo 的结构化位置,让 agent 先拿地图、再按需导航、最后把新增知识写回系统。
本节新增信息图
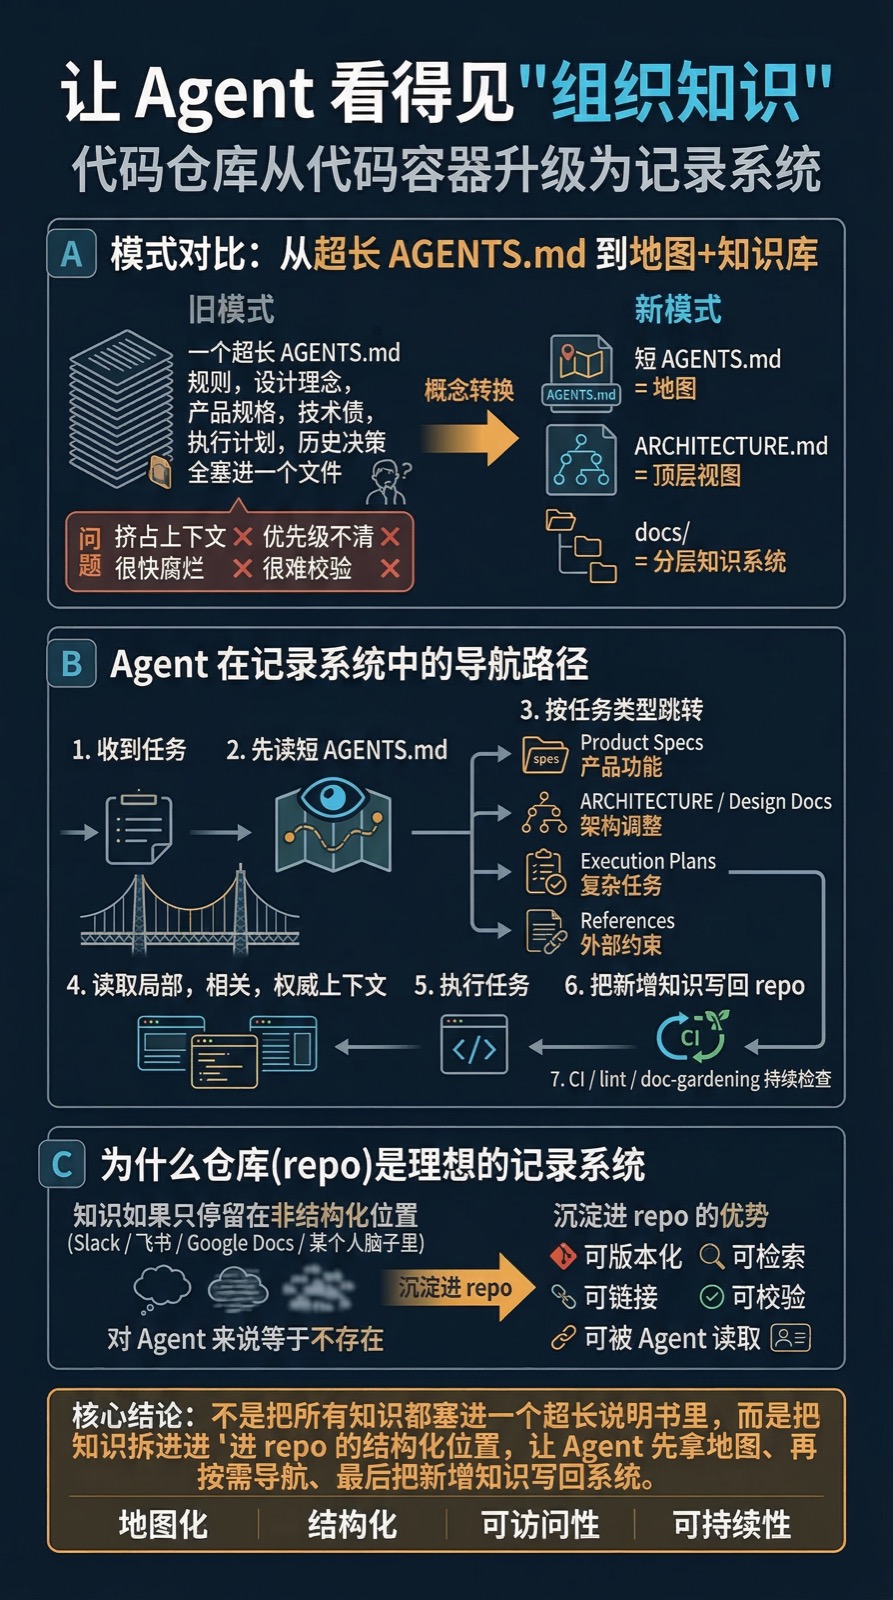
图片路径: 产物/专题信息图/openai-harness-flow-3-record-system/infographic.png
13. 本节的 5 条启示
- AGENTS.md 要短:它应该是入口,不是百科全书。
- 知识要结构化进 repo:不能散落在聊天和脑内。
- 计划要版本化:复杂任务必须留下执行轨迹和决策记录。
- 文档也要治理:要有 freshness、ownership、cross-link、CI 检查。
- 给 agent 的上下文要可导航:不是越多越好,而是越“能找到正确下一步”越好。
14. 企业化表述
在 agent-first 的研发模式里,代码仓库不再只是代码存储介质,而是集架构知识、产品规格、执行计划、决策记录与规则约束于一体的记录系统;AGENTS.md 的作用也从“详尽说明书”转变为“知识导航地图”。
14. 直白版总结
不是让 AI 背一本厚手册, 而是把团队真正重要的知识,按结构放进 repo,让它能自己找到路。
当前相关文件清单
文字总笔记
产物/专题信息图/OpenAI-Harness-Engineering-精读笔记-完整版.md
信息图文件
产物/专题信息图/openai-harness-flow-1-ui-validation/infographic.png产物/专题信息图/openai-harness-flow-2-observability/infographic.png产物/专题信息图/openai-harness-flow-3-record-system/infographic.png
信息图源文件与提示词
产物/专题信息图/openai-harness-flow-1-ui-validation/source-ui-validation.md产物/专题信息图/openai-harness-flow-1-ui-validation/prompts-infographic.md产物/专题信息图/openai-harness-flow-2-observability/source-observability.md产物/专题信息图/openai-harness-flow-2-observability/prompts-infographic.md产物/专题信息图/openai-harness-flow-3-record-system/source-record-system.md产物/专题信息图/openai-harness-flow-3-record-system/prompts-infographic.md
五、目标是智能体的可读性(Agent legibility is the goal)
这一节几乎是整篇《Harness Engineering》的价值观中枢。
如果把它说得最直白:
Harness engineering 的目标,不是把 agent 变得更神秘,而是把它变得更可见、更可理解、更可预测、更可调试。
作者想强调的不是“让 agent 更聪明”,而是:
让 agent 的行为,从一个会说漂亮话的黑盒,变成一个工程团队能看懂、能追踪、能接管、能审计的执行系统。
1. 这一节的核心意思
“legibility” 在这里不是学术意义上的“解释神经网络内部权重”,而是工程意义上的:
- 你能看见 agent 在做什么
- 你能理解它为什么这么做
- 你能知道它现在做到哪一步
- 你能发现它什么时候偏航
- 你能在必要时插手接管
所以这里更接近下面这几个词的组合:
- 可观测性(observability)
- 可调试性(debuggability)
- 可审计性(auditability)
- 可预测性(predictability)
- 可接管性(intervenability)
一句话说:
不是让 agent 看起来像一个有魔法的自主体,而是让它变成一个行为透明的工程对象。
2. 为什么这件事这么重要?
因为真实生产环境里,最贵的不是“第一次做对”,而是:
- 失败后能不能定位
- 出错后能不能补救
- 下次还能不能稳定复现
- 风险能不能被审计和治理
一个不具备 legibility 的 agent,典型问题是:
- 它失败了,但你不知道卡在哪
- 它调用了工具,但你不知道为什么调
- 它这次做对了,但你不知道下次会不会还对
- 它跑了很多步,但你不知道是在推进还是在空转
- 它语言上很自信,但系统状态其实已经偏航
这种 agent 往往给人的感觉就是:
demo 很惊艳,但不敢托付生产任务。
而真正能落地的系统,通常反而没那么“神”,但它具备:
- 清晰状态
- 明确边界
- 可追踪证据
- 低成本排障
- 人类可介入
所以这一节本质上在说:
在生产环境里,可理解性往往比“看起来更聪明”更重要。
3. 这节真正反对的是什么?
它反对的是一种很常见的 agent 幻觉:
“只要模型足够强,可靠性自然会涌现。”
作者给出的隐含答案其实是相反的:
可靠性并不主要来自模型智力本身,而是来自外部 harness 给予它的结构化约束与可见性。
也就是说,agent 是否可用,很多时候不取决于它“脑子有多大”,而取决于系统有没有把这些东西设计出来:
- 显式状态
- 工具调用边界
- 中间产物
- 错误结构
- 审计轨迹
- 人工审批点
- 回滚与恢复机制
换句话说:
agent 的工程价值,很多不是从 intelligence 自然长出来的,而是从 harness 的结构中“长”出来的。
4. “Agent legibility”具体体现在哪?
我把这一节拆成 5 个最实战的维度。
1)状态要显式,不要全藏在模型脑子里
好的 harness 不会让 agent “默默执行”。
它会把过程拆成清晰阶段,比如:
- 理解任务
- 制定计划
- 搜集信息
- 执行动作
- 校验结果
- 输出交付
这样做的价值是:
- 你知道它当前在哪一阶段
- 你知道是哪个阶段出了问题
- 你知道是否可以从某一步恢复
所以:
状态可见,系统才可控。
2)工具调用要有理由,不只是有记录
不是只记录“agent 调了哪个工具”,而是最好能回答:
- 为什么调用这个工具?
- 为什么是现在调用?
- 调用前做了什么判断?
- 调用后结果是否符合预期?
否则你得到的只是流水账,不是 legibility。
3)中间产物要保留,不能只有最终答案
legibility 很大一部分来自“中间层可见”。
比如:
- 提取出的事实
- 形成的计划
- 每一步草稿
- 工具返回结果
- 校验报告
- 决策依据
这些东西会把“看起来像灵感”的过程,变成“可复盘的执行链”。
4)错误要结构化,不要只说失败
真正可维护的 agent,不只是会说“我失败了”,而是会说明:
- 失败在哪一步
- 失败原因是什么
- 是否可重试
- 推荐补救动作是什么
- 是否需要人工接管
这一步非常关键,因为它决定了 agent 是一个“会犯错的黑盒”,还是一个“可维护的工程系统”。
5)人类要能低成本接管
legibility 的终点不是让人类旁观,而是让人类在关键节点能介入。
例如:
- 修改计划再继续
- 审批高风险动作
- 替换错误上下文
- 回滚到上一步
- 插入人工判断
如果系统不可理解,人类甚至不知道该从哪接手。
所以:
legibility 的真正作用,是把“人类监督”从口号变成可执行机制。
5. 它和传统“可解释 AI”有什么不同?
这里的 legibility,不是在追问:
- 模型为什么激活了某个神经元
- 某个 token 为什么概率更高
- 内部权重如何形成某个结论
它更偏工程问题:
- 系统行为是否透明
- 错误是否可定位
- 风险是否可审计
- 决策是否可追踪
- 人类是否可接管
所以它更接近:
- 分布式系统里的 observability
- 工作流系统里的 auditability
- 安全系统里的 traceability
只是对象从“服务调用链”变成了“agent 的行动链”。
6. 为什么 agent 比普通 chatbot 更需要 legibility?
因为 agent 比普通问答系统多了三层风险。
第一层:它会行动
普通聊天模型主要输出文字;agent 会:
- 调工具
- 改文件
- 发消息
- 查系统
- 触发工作流
一旦会行动,不可见就危险。
第二层:它会跨步骤推进
不是一次性回答,而是多步链式决策。
多一步,就多一层偏差放大。
第三层:它“看起来像知道自己在做什么”
这是最容易误导人的地方。
agent 语言上往往非常自信,但流程上可能已经偏航。 所以越 autonomous,越需要 legibility。
7. 这一节真正想把我们从哪里拉回来?
我觉得作者是在把读者从一种“AI 神话”里往回拽:
旧想象:
- agent = 一个很聪明、会自主完成任务的数字员工
作者想要的新想象:
- agent = 一个需要被工程化管理、被约束、被观测、被审计的执行系统
也就是把关注点从:
- autonomy
- intelligence
- magic
拉回到:
- observability
- controllability
- debuggability
这其实是很成熟的工程视角。
因为生产系统最怕的不是“不够聪明”,而是:
出了问题,没有人知道为什么。
8. 这一节可以提炼出的三个设计原则
原则 1:把隐式决策外显化
能写出来的计划、状态、依据、步骤,就不要全藏在 prompt 和模型上下文里。
原则 2:把 agent 行为变成可检查的流水
每一步都能回看、定位、复盘、审计。
原则 3:优先设计失败后的可处理性
不是只优化成功路径,而是优先考虑:
- 如何发现失败
- 如何定位失败
- 如何接管失败
- 如何恢复执行
9. 和前两节之间的关系
这一节其实是前两节的总纲:
第一节:提高应用程序的可读性
让 agent 看得见 应用界面与运行状态。
第二节:将代码仓库设为记录系统
让 agent 看得见 组织知识、规则、计划与决策。
第三节:目标是智能体的可读性
把前两节再往上提一层:
不仅应用要可读、repo 要可读,连 agent 自己的行为也必须可读。
所以三节连起来,其实是一个完整递进:
- 让 agent 看得见应用
- 让 agent 看得见知识系统
- 让人类也看得见 agent 自己
这是一个非常漂亮的结构。
10. 企业化表达
在企业级 agent 系统中,真正需要工程化优化的,不只是模型能力本身,更是 agent 行为的可读性:其状态、决策依据、工具调用、中间产物、错误类型与人工接管点,都应当被设计为可观测、可追踪、可审计、可恢复。
11. 直白版总结
一个不可理解的强 agent,通常不如一个可理解的中等 agent 更值得上线。
或者再压缩成一句:
Harness engineering 的目标,不是放大 agent 的神秘感,而是消除它的神秘感。
当前相关文件清单
文字总笔记
产物/专题信息图/OpenAI-Harness-Engineering-精读笔记-完整版.md
信息图文件
产物/专题信息图/openai-harness-flow-1-ui-validation/infographic.png产物/专题信息图/openai-harness-flow-2-observability/infographic.png产物/专题信息图/openai-harness-flow-3-record-system/infographic.png产物/专题信息图/openai-harness-flow-4-agent-legibility/infographic.png
信息图源文件与提示词
产物/专题信息图/openai-harness-flow-1-ui-validation/source-ui-validation.md产物/专题信息图/openai-harness-flow-1-ui-validation/prompts-infographic.md产物/专题信息图/openai-harness-flow-2-observability/source-observability.md产物/专题信息图/openai-harness-flow-2-observability/prompts-infographic.md产物/专题信息图/openai-harness-flow-3-record-system/source-record-system.md产物/专题信息图/openai-harness-flow-3-record-system/prompts-infographic.md产物/专题信息图/openai-harness-flow-4-agent-legibility/source-agent-legibility.md产物/专题信息图/openai-harness-flow-4-agent-legibility/prompts-infographic.md
本节新增信息图
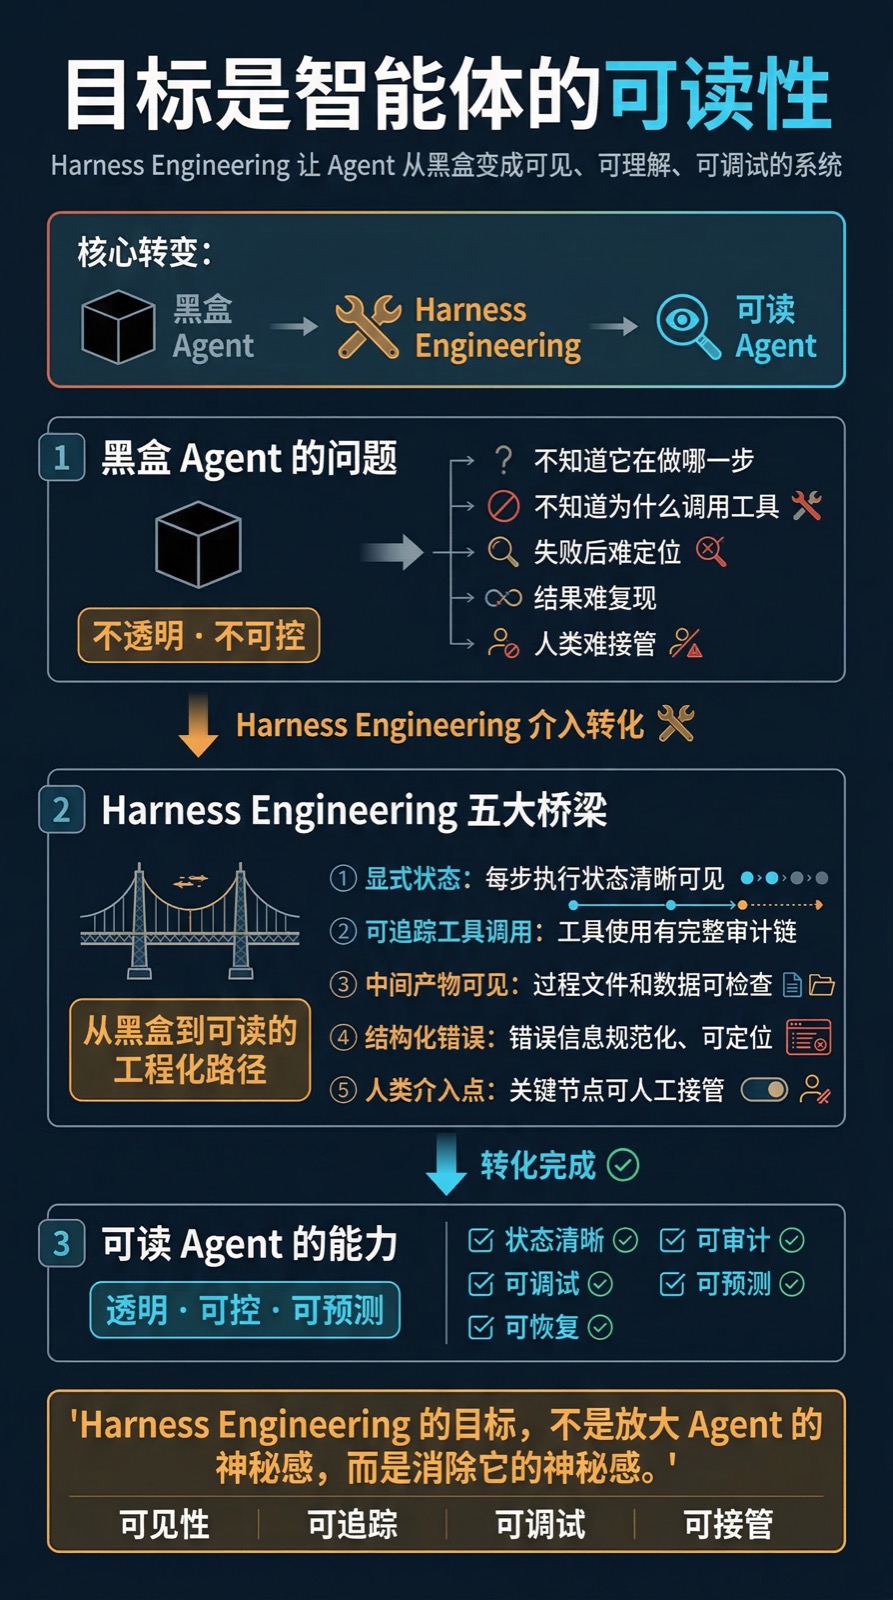
图片路径: 产物/专题信息图/openai-harness-flow-4-agent-legibility/infographic.png
六、规范架构与品味(Enforcing architecture and taste)
这一节真正讨论的,不只是如何让 agent 写出“能运行”的代码,而是:
当 agent 开始高吞吐地产出代码时,如何确保它写出来的东西仍然符合你们团队的架构原则、工程风格与产品审美。
如果上一节强调的是“让 agent 可读(legible)”,这一节强调的就是:
不仅要看得见 agent 在做什么,还要让它按“正确的方式”去做。
1. 这一节的核心意思
当 agent 能持续写代码时,问题很快就不再是“它会不会写”,而变成:
- 它写得是否符合现有架构?
- 是否遵守模块边界?
- 是否延续团队已有模式?
- 是否体现产品判断?
- 是否保持一致的工程审美?
- 是否在局部完成任务的同时,悄悄破坏整体系统?
所以这一节真正想解决的是:
让 agent 的产出,不只是局部正确,而是整体上“长得像这套系统本来就应该有的样子”。
2. 为什么要把 “taste” 单独提出来?
因为很多团队会默认:
- 架构可以写成规则
- 但 taste 太主观,没法系统化
OpenAI 这里的判断更成熟:
如果你不显式表达 taste,agent 就会用模型的“平均默认值”来补这个空。
而这种平均默认值往往意味着:
- 能跑,但不优雅
- 能交付,但不统一
- 局部合理,但长期不可维护
- 看起来没错,但越来越不像“你们自己的系统”
所以 taste 不是装饰性的审美,而是:
团队长期积累下来的高维判断压缩。
它决定了什么算:
- 好的 abstraction
- 自然的 API 设计
- 克制的交互方式
- 清爽的页面层级
- 不过度设计但又不偷懒的实现路径
3. 这一节其实在讲两层约束
1)Architecture:硬约束
这部分更像系统骨架,比较容易写成明确规则,比如:
- 哪些层可以依赖哪些层
- 哪些模块不能互相调用
- 数据流应如何组织
- 状态应该放在哪里
- 哪类能力必须走统一入口
- 哪些模式是标准做法,哪些是禁止做法
这一层解决的是:
系统结构不能乱。
2)Taste:软约束
这部分更微妙,也更接近资深工程师和产品人的“感觉”:
- 一个页面怎样才算清爽?
- 一个 abstraction 怎样才算不过度设计?
- 一个 API 怎样才算顺手?
- 一段代码应该偏直接还是偏抽象?
- 什么时候该复用,什么时候该重写?
- 一个默认行为应该更自动还是更显式?
这些未必都能写成 lint rule,但它们真实决定了:
系统最终会长成什么样。
4. 为什么 agent 时代这件事更重要?
因为在低吞吐时代,很多 taste 问题可以靠人工 review 慢慢纠偏:
- 一周几个 PR
- reviewer 还能逐个指出“这写法不对味”
但当 agent 把产出速度大幅提高后,这种靠资深工程师“手工校味”的方式就不够了。
如果 taste 只存在于少数人脑子里,那么高吞吐开发下系统会迅速出现:
- 架构漂移
- 风格漂移
- 体验漂移
- 复杂度上升
- 代码越来越碎
所以这一节的关键判断是:
高吞吐 agent 开发,倒逼团队把原本隐性的架构共识与审美共识显式化。
5. 这一节反对什么?
它反对一种非常常见但很危险的想法:
“只要测试通过,代码就是好的。”
测试当然重要,但测试只能证明一部分 correctness,不能保证:
- 架构没有被侵蚀
- 系统没有变得更脆
- 代码没有变丑
- 产品体验没有退化
- 长期维护成本没有悄悄上升
所以:
- 测试解决的是:行为是否基本正确
- architecture + taste解决的是:系统是否持续保持高质量形状
这一节强调的,是后者。
6. 如何理解 “enforcing architecture”?
最直白的翻译是:
不让 agent 为了完成眼前任务,偷系统的未来。
常见的架构侵蚀方式包括:
- 为了快,绕过既有抽象
- 为了修 bug,直接跨层访问
- 为了省事,把不该耦合的逻辑绑在一起
- 为了复用,做出错误抽象
- 为了局部通过,破坏全局一致性
agent 特别容易做这些事,因为它天然倾向于:
- 找最短路径
- 满足当前任务
- 做局部最优
- 不自动承担长期维护责任
所以没有架构约束,agent 会很快把系统写成一堆“眼前有效、长期糟糕”的补丁。
7. 如何理解 “enforcing taste”?
如果说 architecture 是“不能做什么”,那么 taste 更像是:
什么才算做得漂亮。
同样一个功能,可能有三种写法:
- A:能跑,但很丑
- B:能跑,结构也还行
- C:能跑,而且与整个系统的设计语言、抽象习惯、交互风格一致
资深工程师和成熟产品团队通常会偏向 C。
问题是,如果你不把这种偏好显式表达出来,agent 往往会交付 A 或 B,甚至觉得自己完成得很好。
所以 enforcing taste,本质上是在做:
- 把优秀团队的默认判断显式化
- 把“看过很多代码之后形成的感觉”变成可传递标准
- 让 agent 学会不仅“完成”,还要“完成得像我们”
这其实是一种组织级知识蒸馏。
8. 这一节隐含的组织要求
这一节背后有一个很强的前提:
团队必须先知道自己想成为什么样,才能要求 agent 按那个样子产出。
很多团队的问题不是 agent 不够聪明,而是团队自己并没有明确:
- 我们的架构原则是什么?
- 我们反对什么模式?
- 我们偏好的抽象粒度是什么?
- 我们的产品风格是什么?
- 我们的 UX 审美是什么?
- 我们判断“好代码”的标准是什么?
如果这些都不清楚,agent 只能去猜。猜出来的,大概率就是统计均值,而不是团队风格。
9. 和前三节之间的关系
这节和前面三节是递进关系:
第一节:提高应用程序的可读性
让 agent 看得见 应用界面与运行状态。
第二节:将代码仓库设为记录系统
让 agent 看得见 组织知识、规则、计划与决策。
第三节:目标是智能体的可读性
让人类看得见 agent 自己的状态、行动、错误与接管点。
第四节:规范架构与品味
进一步要求:
不仅要看得见,还要持续确保 agent 按系统认可的方式产出。
也就是:
- legibility 解决“可见”
- architecture 解决“结构正确”
- taste 解决“质量与风格正确”
10. 这一节最值得记住的判断
在 agent 时代,优秀系统不是自然长出来的,而是被持续约束出来的。
这句话很重要,因为 agent 会放大生产力,也会放大漂移速度。
如果没有显式约束,系统会迅速出现:
- 架构漂移
- 风格漂移
- 体验漂移
- 质量漂移
最后每个 PR 看着都没有大错,但整个产品会越来越碎。
11. 这一节可以提炼成 4 个设计原则
原则 1:把架构原则写成 agent 能执行的规则
例如:
- 哪些目录允许改
- 哪些层不能跨
- 哪些能力必须复用既有模块
- 哪些改动必须附 plan / review
原则 2:把 taste 从“感觉”沉淀成示例和对比
不要只说“写得优雅一点”,要给:
- 正例
- 反例
- before / after
- preferred patterns
原则 3:把 review 从“事后挑错”前移为“事前约束”
不是等 PR 出来了再说“不够像我们”,而是让 agent 一开始就按这些标准生成。
原则 4:把长期质量视为一等目标
不只看任务完成率,还看:
- 一致性
- 可维护性
- 复杂度控制
- 产品感
- 系统完整性
12. 企业化表达
在高吞吐智能体研发模式下,组织必须把原本依赖资深工程师隐性掌握的架构约束与质量审美,转化为可文档化、可示例化、可检查、可复用的工程标准,从而确保 agent 的高速产出不会演变为系统性的结构漂移与体验退化。
13. 直白版总结
Agent 不只是要把事做完,还要按“你们团队认可的方式”把事做完。
或者再压缩成一句:
没有 architecture,agent 会乱搭;没有 taste,agent 会写出一堆能跑但不高级的东西。
当前相关文件清单
文字总笔记
产物/专题信息图/OpenAI-Harness-Engineering-精读笔记-完整版.md
信息图文件
产物/专题信息图/openai-harness-flow-1-ui-validation/infographic.png产物/专题信息图/openai-harness-flow-2-observability/infographic.png产物/专题信息图/openai-harness-flow-3-record-system/infographic.png产物/专题信息图/openai-harness-flow-4-agent-legibility/infographic.png产物/专题信息图/openai-harness-flow-5-architecture-taste/infographic.png
信息图源文件与提示词
产物/专题信息图/openai-harness-flow-1-ui-validation/source-ui-validation.md产物/专题信息图/openai-harness-flow-1-ui-validation/prompts-infographic.md产物/专题信息图/openai-harness-flow-2-observability/source-observability.md产物/专题信息图/openai-harness-flow-2-observability/prompts-infographic.md产物/专题信息图/openai-harness-flow-3-record-system/source-record-system.md产物/专题信息图/openai-harness-flow-3-record-system/prompts-infographic.md产物/专题信息图/openai-harness-flow-4-agent-legibility/source-agent-legibility.md产物/专题信息图/openai-harness-flow-4-agent-legibility/prompts-infographic.md产物/专题信息图/openai-harness-flow-5-architecture-taste/source-architecture-taste.md产物/专题信息图/openai-harness-flow-5-architecture-taste/prompts-infographic.md
本节新增信息图
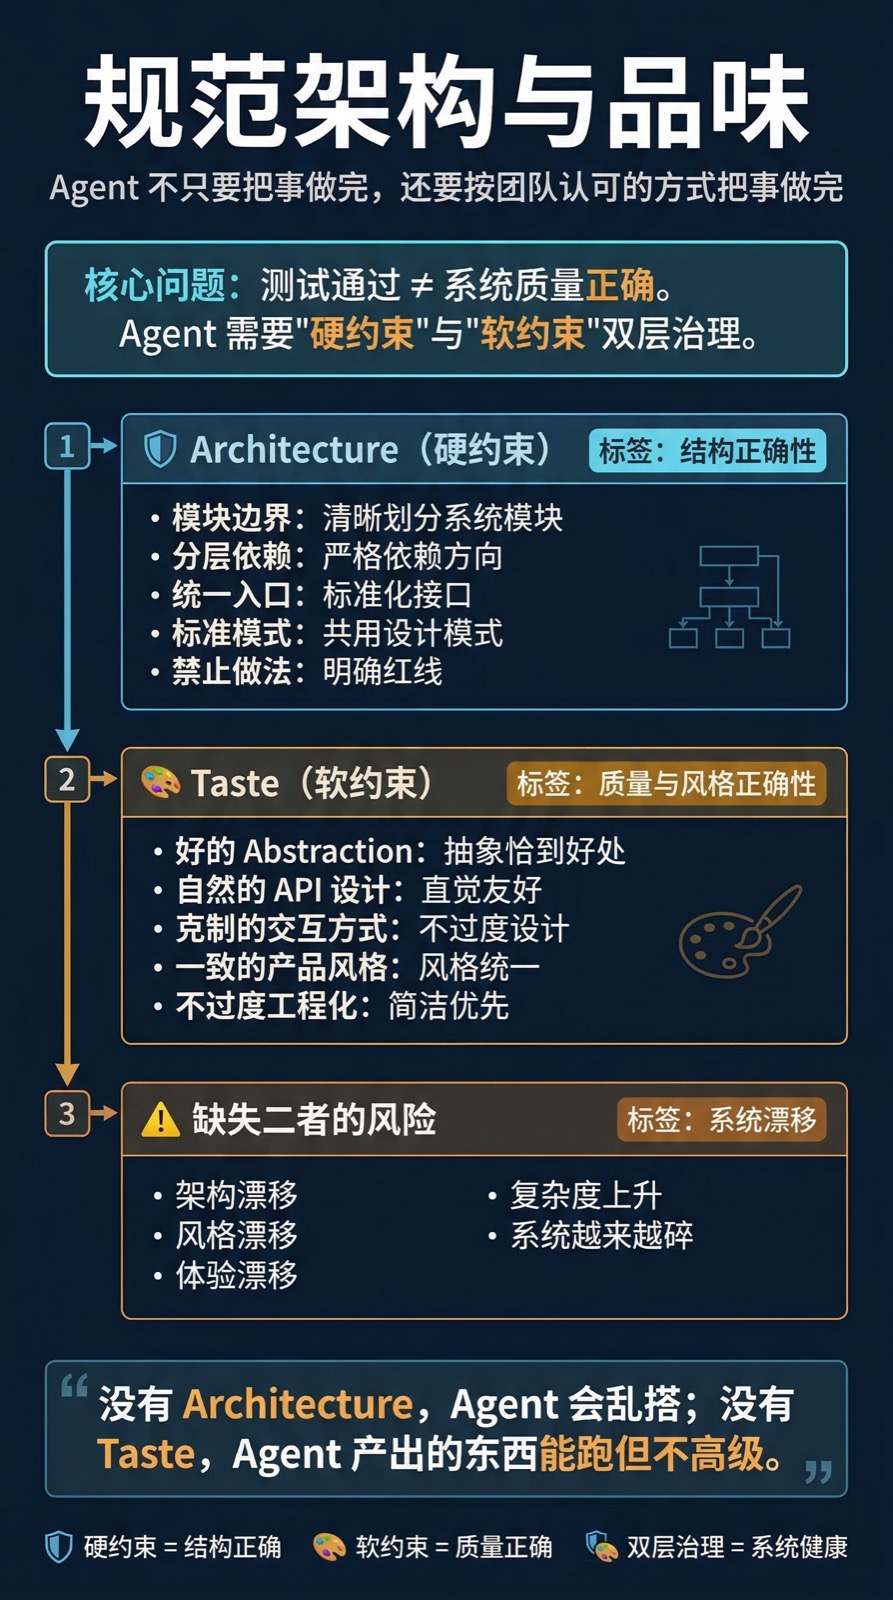
图片路径: 产物/专题信息图/openai-harness-flow-5-architecture-taste/infographic.png
七、后四节合并精读:高吞吐 Agent 的治理转型
这四个小节——
- Throughput changes the merge philosophy
- What “agent-generated” actually means
- Increasing levels of autonomy
- Entropy and garbage collection
合在一起,讲的其实是同一件事:
当 agent 不再只是“偶尔帮你写点代码”,而是开始持续、高吞吐、半自主地参与研发时,团队必须重写自己的交付哲学、归因哲学、授权哲学与系统维护哲学。
前四节更像是在搭地基:
- 让应用可读
- 让 repo 成为记录系统
- 让 agent 行为可读
- 让架构与品味可被约束
而这后四节是在回答一个更现实的问题:
好,就算这些都做了,当 agent 真正进入高吞吐生产后,团队会发生什么变化?
1. 一条完整的递进链
这四节并不是四个散点,而是一条连续的治理链:
-
Throughput changes the merge philosophy
当产出吞吐量暴涨,合并代码的哲学必须改变。 -
What “agent-generated” actually means
你得重新理解,什么叫“这是 agent 产出的工作”。 -
Increasing levels of autonomy
然后你要决定,agent 到底能自主到什么程度。 -
Entropy and garbage collection
最后你会发现,系统熵会迅速上升,必须建立垃圾回收机制。
压缩成一句话就是:
Agent 不是给现有研发流程加个外挂,而是会迫使团队重构从提交、合并、归因、授权到清理的整套生产系统。
2. Throughput changes the merge philosophy
这一节最关键的意思是:
当 agent 让代码产出速度大幅提升后,团队不能再继续用过去“低吞吐、高手工审查”的合并逻辑来管理代码进入主干。
过去的 merge philosophy 往往隐含几个前提:
- PR 数量有限
- reviewer 能逐个认真看
- 每个改动都相对昂贵
- 合并是一个偏慎重、稀缺的动作
- 人类 review 是最主要的质量门
但一旦 agent 上来,这些前提就会被打穿:
- PR 数量会变多
- 改动粒度会变小
- 验证链会更自动化
- 人类不可能逐条深读所有改动
- “看 diff”不再是唯一核心动作
所以 merge philosophy 必须改变。
它会改成什么?
核心不是更宽松,而是:
从“逐个人工把关代码文本”转向“依赖更强的系统化门禁、自动验证与后验监控”。
也就是说,未来更重要的不是:
- reviewer 有没有把每一行代码都看懂
而是:
- 这个改动是否通过了足够好的自动验证?
- 是否满足架构约束?
- 是否满足质量门禁?
- 是否可回滚?
- 是否处在可观测范围内?
- 是否能在问题出现后快速定位和处理?
这一节真正的潜台词是:
在高吞吐时代,merge 不再主要是“证明这段代码完美”,而是“确认这个改动进入系统后,风险在可控范围内”。
3. What “agent-generated” actually means
这一节在纠正一个很粗糙的理解:
“agent-generated” 不是说 agent 独立、神秘地写出一段代码,然后人类被动接受。
真正的 “agent-generated” 往往意味着:
- agent 读取了大量现有上下文
- 使用了团队提供的架构规则和 taste 规则
- 调用了 repo 里的计划、文档、工具链
- 跑了测试、查了日志、走了验证链
- 在人类预先设计的 harness 中执行
所以更准确的说法是:
所谓 agent-generated,本质上不是“AI 单独创作”,而是“组织能力经过 harness 编排后,由 agent 执行出来的结果”。
这件事很重要,因为如果你把 agent-generated 理解成“模型自己写的”,你就会看错问题。
更准确的理解应该是:
agent 的输出,是模型能力 + harness 设计 + 上下文质量 + 工具能力 + 规则约束 + 审核流程 的共同产物。
所以 agent-generated 代码,不只是“模型的作品”,更是:
- 团队知识的外化
- 平台能力的映射
- 组织约束的投影
- 工作流设计的结果
换句话说:
agent 生成的,很多时候不是“代码本身”,而是“组织生产系统对任务的响应”。
4. Increasing levels of autonomy
这一节回答的是一个非常现实的问题:
agent 到底该被放权到什么程度?
因为自主性不是一个开关,而是一条连续谱。
大致可以分成这样几层:
Level 1:辅助型
- 只提建议
- 只写草稿
- 不直接执行
- 人类全程确认
Level 2:执行型
- 可以在明确边界内改代码、跑测试、修 bug
- 但高风险动作仍要审批
Level 3:任务闭环型
- 能自己计划、执行、验证、迭代
- 人类只在关键节点介入
Level 4:高自治型
- 大量任务可以自动完成
- 人类主要做异常处理、目标设定和策略控制
这一节的关键不是“越高越好”,而是:
自主性必须与 legibility、约束、门禁、回滚能力一起增长。
也就是说,真正正确的关系不是:
更强模型 → 更高自主性
而是:
更高可读性 + 更强约束 + 更稳验证 + 更低回滚成本 → 才能支撑更高自主性
一句话总结:
autonomy 不是奖励模型聪明,而是奖励系统可控。
5. Entropy and garbage collection
这一节像是整组里的“冷水时刻”。
前面都在讲怎么让 agent 更强、更快、更可用;这一节提醒的是:
即使前面都做得不错,只要 agent 持续高吞吐地产出,系统熵仍然会增加。
这是必然的。熵会体现在:
- repo 里堆积很多中间产物
- plan、文档、规则会老化
- 小型抽象越来越多
- 局部优化堆积成复杂性
- 无人再看的辅助脚本变多
- 临时结构变长期结构
- “为当前任务成立”的东西被永久留下
所以这里的 garbage collection,不只是删文件,而是:
持续清理 agent 时代系统中不断积累的低价值、过期、冗余、失配结构。
包括:
- 过期文档
- 失效计划
- 临时规则
- 低质量抽象
- 重复工具
- 无人维护脚本
- 没再被引用的知识块
- 已不符合当前架构的旧模式
也就是说,agent 时代不只是要会“生成”,还要会:
- 修枝
- 收敛
- 清理
- 压缩复杂度
否则系统会逐渐变成一个“什么都有一点,但越来越不好维护”的有机堆积物。
6. 这四节合起来,真正讲的是哪种研发范式转变?
如果要给它起一个更大的标题,我会叫:
从“手工稀缺开发”转向“机器高吞吐开发”的治理转型。
在手工稀缺开发时代,团队默认靠这些东西维持秩序:
- 资深工程师的眼力
- 逐个 PR review
- 慢速合并
- 人工判断归因
- 人工控制授权
- 人工发现系统变脏
但在 agent 高吞吐开发时代,这些都不够了。你必须把秩序机制重建为系统化能力:
- 自动验证
- 显式归因
- 分级自主性
- 持续清理
- 可回滚设计
- 可观测治理
- 规则前移
- 质量门禁自动化
所以这四节真正描述的是:
当生产力被 agent 放大后,工程组织如何避免自己被这股生产力反噬。
7. 最漂亮的内在逻辑
可以把这四节串成一条完整链:
1)Throughput changes the merge philosophy
因为 agent 让产出变多了
→ 所以你不能再靠传统 merge 模式
2)What “agent-generated” actually means
因为这些产出其实不是单纯模型写的
→ 而是组织 harness 的产物
→ 所以问题和责任不能只归给“模型”
3)Increasing levels of autonomy
既然 agent 是组织流程中的执行体
→ 那就必须明确它能自主到什么级别
→ 不能模糊放权
4)Entropy and garbage collection
即使放权合理、流程完善
→ 高吞吐系统仍然会积累熵
→ 所以必须建立常态化清理机制
这条链非常完整,几乎构成了 agent 工程后半篇的治理总纲。
8. 这四节可以提炼出的 6 条总原则
原则 1:吞吐量上升时,merge 逻辑必须系统化
不能再主要依赖人肉逐条看 diff。
原则 2:agent 输出是组织系统产物,不只是模型产物
所以治理重点是 harness,不只是模型。
原则 3:autonomy 必须分级
自主性要随着可见性、约束和回滚能力一起上升。
原则 4:默认假设熵会上升
不要假设高吞吐系统会自动保持整洁。
原则 5:清理能力和生成能力同等重要
没有 garbage collection,生成能力越强,系统越快变脏。
原则 6:团队必须从“工匠式守门”转向“平台式治理”
真正的瓶颈会从“谁会写代码”转向“谁能设计高质量约束系统”。
9. 企业化表达
在智能体驱动的高吞吐研发模式下,组织不能继续依赖低频人工审查、模糊责任归属和隐性经验维持质量,而必须建立一套围绕自动验证、显式归因、分级自治、持续清理与可回滚控制的工程治理体系,以吸收生产力提升带来的复杂性外溢。
10. 直白版总结
Agent 把“写代码”变便宜以后,真正变贵的是治理。
或者再狠一点:
不是 agent 会不会写,而是你有没有能力承接它写出来的规模。
当前相关文件清单
文字总笔记
产物/专题信息图/OpenAI-Harness-Engineering-精读笔记-完整版.md
信息图文件
产物/专题信息图/openai-harness-flow-1-ui-validation/infographic.png产物/专题信息图/openai-harness-flow-2-observability/infographic.png产物/专题信息图/openai-harness-flow-3-record-system/infographic.png产物/专题信息图/openai-harness-flow-4-agent-legibility/infographic.png产物/专题信息图/openai-harness-flow-5-architecture-taste/infographic.png产物/专题信息图/openai-harness-flow-6-throughput-autonomy-entropy/infographic.png
信息图源文件与提示词
产物/专题信息图/openai-harness-flow-1-ui-validation/source-ui-validation.md产物/专题信息图/openai-harness-flow-1-ui-validation/prompts-infographic.md产物/专题信息图/openai-harness-flow-2-observability/source-observability.md产物/专题信息图/openai-harness-flow-2-observability/prompts-infographic.md产物/专题信息图/openai-harness-flow-3-record-system/source-record-system.md产物/专题信息图/openai-harness-flow-3-record-system/prompts-infographic.md产物/专题信息图/openai-harness-flow-4-agent-legibility/source-agent-legibility.md产物/专题信息图/openai-harness-flow-4-agent-legibility/prompts-infographic.md产物/专题信息图/openai-harness-flow-5-architecture-taste/source-architecture-taste.md产物/专题信息图/openai-harness-flow-5-architecture-taste/prompts-infographic.md产物/专题信息图/openai-harness-flow-6-throughput-autonomy-entropy/source-throughput-autonomy-entropy.md产物/专题信息图/openai-harness-flow-6-throughput-autonomy-entropy/prompts-infographic.md
本节新增信息图
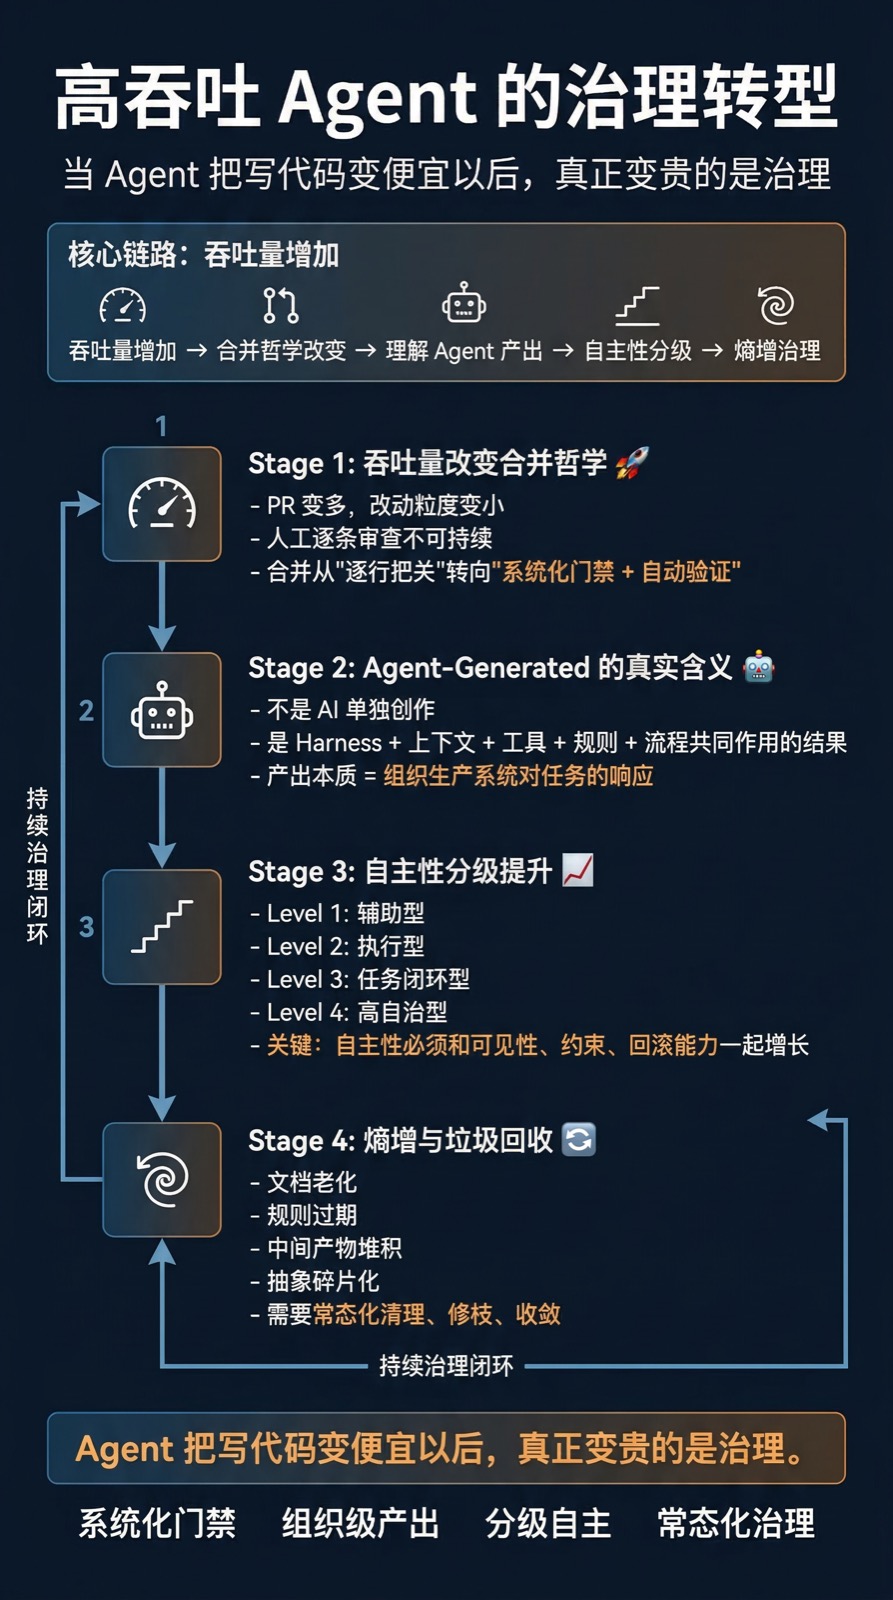
图片路径: 产物/专题信息图/openai-harness-flow-6-throughput-autonomy-entropy/infographic.png
八、我们仍在学习的内容(What we’re still learning)
这一节很短,但我觉得它在整篇文章里非常重要。
因为前面几节一路讲下来,很容易让人产生一种错觉:
OpenAI 已经把 agent engineering 这套东西完全跑通了,剩下只是规模化复制。
而这一节的作用,恰恰是把这种错觉拉回来。
作者在这里传达的真正态度是:
即使已经建立了 harness、可观测性、记录系统、架构约束、自主性分级与垃圾回收机制,agent engineering 仍然是一个高度演化中的实践,而不是已经完全稳定的工业标准。
这是一种非常成熟的收尾方式。
1. 这一节的核心意思
前文讲了很多“已经有效的方法”,但这一节提醒我们:
- 这些方法有效,不等于已经完美
- 这些流程成型,不等于已经定型
- 这些原则成立,不等于适用于所有团队、所有任务、所有阶段
所以这节真正想表达的是:
agent engineering 不是一套一次性设计完的体系,而是一套需要持续校准、持续实验、持续修正的操作系统。
换句话说,前面讲的不是“最终答案”,更像是:
- 当前最有效的一组工作原则
- 一套被实践验证过、但仍会变化的工程范式
- 一种还在不断被现实打磨的组织能力
2. 为什么这节特别重要?
因为 agent 领域最危险的两种认知偏差是:
偏差 1:过度乐观
觉得:
- 模型越来越强
- harness 已经搭起来了
- 流程已经自动化了
- 所以剩下只是继续提速
偏差 2:过度悲观
觉得:
- agent 还经常犯错
- 自主性仍然有限
- 系统熵还很高
- 所以这条路根本不可靠
而这一节更像是在两者之间给出一个更稳的判断:
这条路是对的,但远没有结束。
也就是说:
- 不需要神化 agent
- 也不需要否定 agent
- 真正需要的是持续学习、持续纠偏、持续把经验工程化
3. 这一节背后的真正方法论
如果把它抽象出来,我觉得它在强调 4 个方法论。
1)把 agent engineering 当成实验科学,而不是一次性交付
很多团队容易把 agent 平台想成一个普通软件项目:
- 需求明确
- 方案设计
- 开发上线
- 稳定运行
但 agent 工程更像实验科学:
- 假设
- 试验
- 观察
- 修正
- 再试验
因为变量太多:
- 模型在变化
- 工具链在变化
- 任务类型在变化
- 组织配合方式在变化
- 风险边界也在变化
所以这件事天然不是“一次做完”,而是“持续演化”。
2)把失败当成系统信号,不只是局部事故
在 agent 系统里,失败往往不是单点 bug,而是:
- harness 边界没设对
- 上下文设计不够好
- 自主性放权过头
- 验证链不够强
- 文档系统不够新鲜
- 审计机制不够可用
所以“失败”本身就是输入。
每一次失败,都是在暴露系统设计里尚未被工程化的部分。
3)把经验沉淀速度做快
这一节也在暗示:
真正的竞争力,不只是“谁先用 agent”,而是“谁能更快把使用 agent 的经验沉淀成新的规则、流程和平台能力”。
也就是说,领先的不是一次成功,而是:
- 失败后复盘更快
- 规则更新更快
- harness 迭代更快
- 经验外化更快
4)承认“最优做法”会不断移动
今天有效的:
- merge 哲学
- autonomy level
- prompt pattern
- review 方式
- 文档组织形式
明天都可能继续变化。
所以这一节其实是在反对一种僵化心态:
不要把当前最佳实践误当成永恒真理。
4. 和前面所有章节的关系
这一节像是给前面所有章节加了一个总注脚:
前面讲的是什么?
- 如何让应用对 agent 可读
- 如何让 repo 成为记录系统
- 如何让 agent 自身可读
- 如何约束 architecture 和 taste
- 如何在高吞吐下重构 merge、归因、自主性与 garbage collection
最后一节补上的是什么?
- 这些都重要
- 这些都有效
- 但这些都仍然在进化中
所以最后这一节不是在削弱前面的结论,而是在提升它们的真实度。
它告诉我们:
不要把 agent engineering 理解成一套固定答案,而要把它理解成一种持续学习的工程能力。
5. 这一节最值得记住的判断
如果我提炼一句最值得带走的话,会是:
在 agent 时代,组织的核心能力不只是部署智能体,而是持续学习如何部署智能体。
这句话和整篇文章的气质非常一致。
因为到最后,真正稀缺的并不是:
- access to model
- 一次性的自动化脚本
- 某个单点很强的 demo
而是:
- 不断校准 harness 的能力
- 不断重写规则的能力
- 不断压缩熵的能力
- 不断把经验转成组织资产的能力
6. 企业化表达
从组织视角看,agent engineering 并不是一套已经固化的交付模板,而是一种持续演化的能力建设过程。真正可持续的优势,不来自一次性部署智能体,而来自组织能否持续吸收失败信号、更新约束系统、迭代工作流,并将经验快速沉淀为新的平台能力与治理规范。
7. 直白版总结
Agent engineering 没有“已经学完”的时刻,只有“学习速度够不够快”的区别。
或者更口语一点:
最后真正拉开差距的,不是谁先上 agent,而是谁学得更快、改得更快。
当前相关文件清单
文字总笔记
产物/专题信息图/OpenAI-Harness-Engineering-精读笔记-完整版.md
信息图文件
产物/专题信息图/openai-harness-flow-1-ui-validation/infographic.png产物/专题信息图/openai-harness-flow-2-observability/infographic.png产物/专题信息图/openai-harness-flow-3-record-system/infographic.png产物/专题信息图/openai-harness-flow-4-agent-legibility/infographic.png产物/专题信息图/openai-harness-flow-5-architecture-taste/infographic.png产物/专题信息图/openai-harness-flow-6-throughput-autonomy-entropy/infographic.png
信息图源文件与提示词
产物/专题信息图/openai-harness-flow-1-ui-validation/source-ui-validation.md产物/专题信息图/openai-harness-flow-1-ui-validation/prompts-infographic.md产物/专题信息图/openai-harness-flow-2-observability/source-observability.md产物/专题信息图/openai-harness-flow-2-observability/prompts-infographic.md产物/专题信息图/openai-harness-flow-3-record-system/source-record-system.md产物/专题信息图/openai-harness-flow-3-record-system/prompts-infographic.md产物/专题信息图/openai-harness-flow-4-agent-legibility/source-agent-legibility.md产物/专题信息图/openai-harness-flow-4-agent-legibility/prompts-infographic.md产物/专题信息图/openai-harness-flow-5-architecture-taste/source-architecture-taste.md产物/专题信息图/openai-harness-flow-5-architecture-taste/prompts-infographic.md产物/专题信息图/openai-harness-flow-6-throughput-autonomy-entropy/source-throughput-autonomy-entropy.md产物/专题信息图/openai-harness-flow-6-throughput-autonomy-entropy/prompts-infographic.md
九、全篇总览信息图
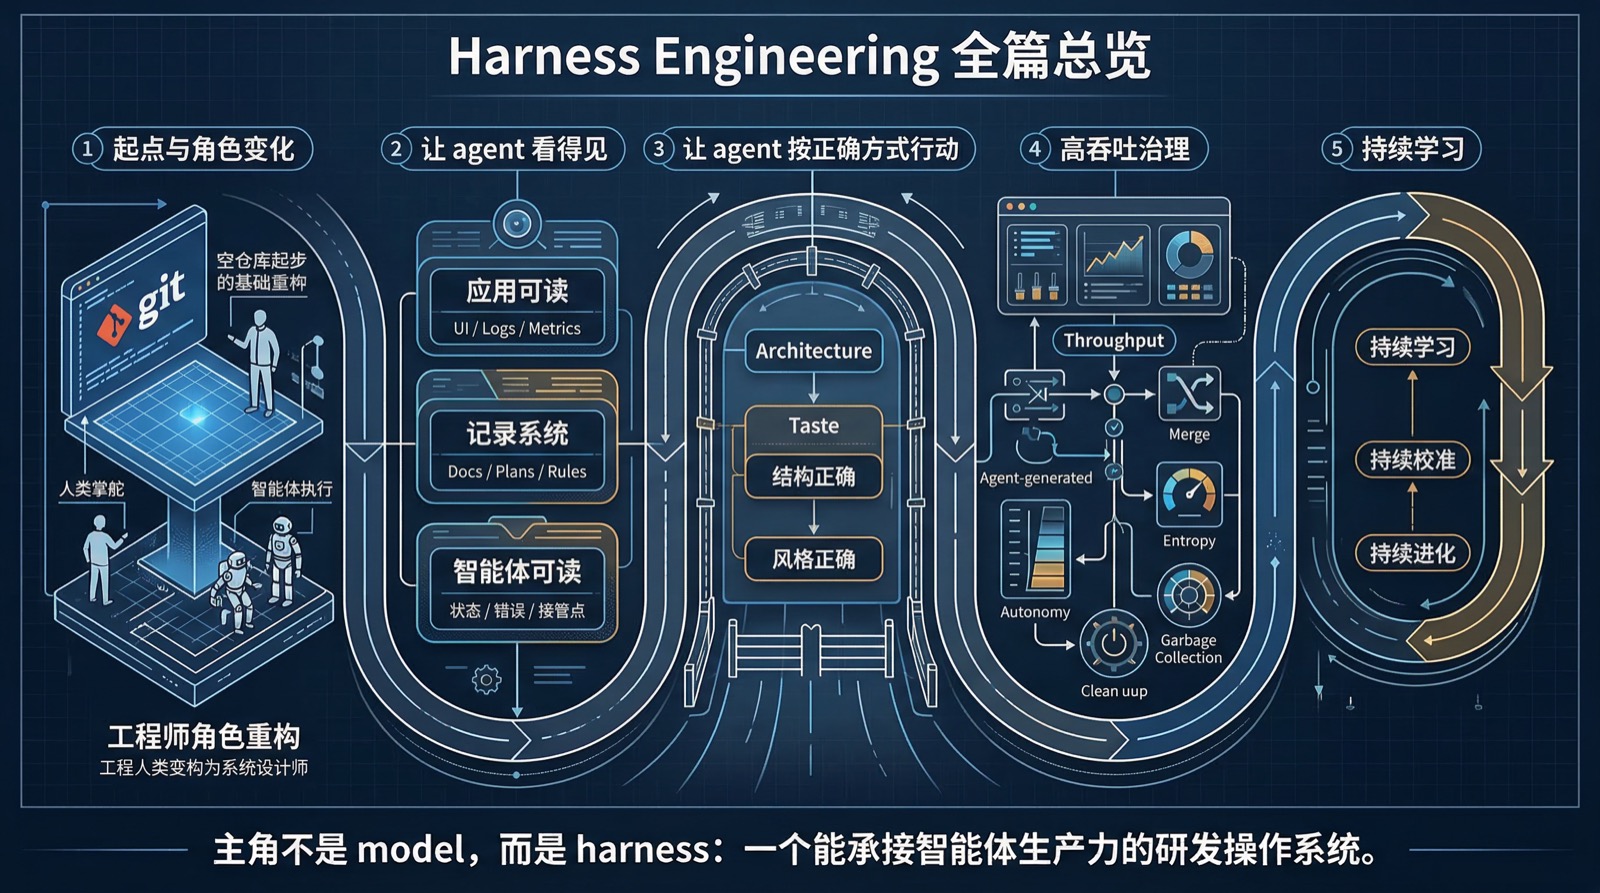
图片路径: 产物/专题信息图/openai-harness-overview/infographic.png
素材目录: 产物/专题信息图/openai-harness-overview/
包含:
source-harness-overview.mdanalysis.mdstructured-content.mdprompts-infographic.mdinfographic.png
十、完整精读总收束
如果把整篇《Harness Engineering》压缩成一句话,我会这样总结:
Agent engineering 的本质,不是把一个更聪明的模型接进研发流程,而是把整个研发组织重构成一个 agent 能看懂、能执行、能被约束、能被审计、能持续进化的生产系统。
再直白一点:
重点从来不只是模型有多强,而是你的系统、规则、知识、门禁、回滚、清理与学习机制,能不能承接模型带来的新生产力。
这也是为什么整篇文章最重要的主角,其实不是 model,而是 harness。